
Inkling 2 Mini: Yerel Yapay Zekâyı Kendi İşinizle Nasıl Değerlendirirsiniz?
Thinking Machines'in açık ağırlıklı Inkling 2 Mini modeli yerel kod ve araç kullanımı için yeni bir seçenek. Donanım gereksinimlerini, döngülü mimarinin anlamını, Ollama ile ilk denemeyi ve kaliteyi ölçme yaklaşımını anlatıyorum.
Yerel bir yapay zekâ modeli seçerken ilk soru “en yüksek puanı hangisi aldı?” olmamalı. Model kendi makinenize sığıyor mu, gerçek işinizi doğru yapıyor mu ve onu işletmek ne kadar kaynak gerektiriyor? 20 Kasım 2026'da yayımlanan Inkling 2 Mini, bu soruları yeniden değerlendirmeye değer bir seçenek sunuyor.
Thinking Machines duyurusu, modeli açık ağırlıklarla ve yerel kullanım hedefiyle tanıtıyor. Kod üzerinde çalışan ajanlar, araç kullanan uygulamalar ve görsel girdilerle yürütülen işler öne çıkıyor. Buradaki amaç her projeyi hemen taşımak değil; bulut API'siyle yaptığınız belirli bir işin yerelde ne ölçüde karşılanabildiğini kontrollü biçimde ölçmek.
“Mini” ne anlama geliyor?
Resmî model kartına göre model 26,4 milyar toplam parametreye sahip. Metin ve görsel alıp metin üretiyor; ağırlıkları Apache 2.0 lisansıyla sunuluyor. Genel çok dilli destek belirtiliyor, fakat bu ifade sizin Türkçe destek taleplerinizde veya teknik belgelerinizde belli bir başarı oranını garanti etmiyor.
Model yaklaşık 20 GB'lık bir checkpoint olarak dağıtılıyor. Kart, Apple Silicon cihazlarda en az 32 GB bellek desteğini; diğer GPU ve platformlarda ise 32 GB veya üzeri VRAM önerisini belirtiyor. Bunları bütün bilgisayarlar için eşdeğer performans sözü olarak okumamak gerekiyor. Desteklenen çalıştırıcı, ağırlık biçimi ve cihazın diğer yükleri sonucu etkiler.
Aynı katmanlardan tekrar geçmek ne sağlıyor?
Inkling 2 Mini, “looped transformer” denen bir mimari kullanıyor: 24 katmanın ortadaki 12'si her token için üç kez çalışıyor. Ağırlıkların bir kısmı yeniden kullanılarak token başına daha fazla hesaplama yapılıyor. Bu, uygulamanızın aynı soruyu modele üç ayrı API isteğiyle göndermesiyle aynı şey değil.
Resmî sayfalardaki 3,4 milyar aktif parametre ve döngüler hesaba katıldığında verilen 5,4 milyar etkin ağırlık aktivasyonu sayıları da bu yüzden birbirinin alternatifi değil. Bunlardan hareketle modelin yalnızca 3,4 veya 5,4 GB belleğe ihtiyaç duyduğunu çıkaramazsınız.
Üretici kod görevlerinde güçlü sonuçlar bildiriyor, ancak karşılaştırma düzeneklerinin modele göre değiştiğini de açıklıyor. Aynı duyuruda çok turlu sohbet ve çok sayıda kısıt içeren talimatların zayıf noktalar arasında olduğu belirtiliyor. Bu yazıda modeli kendi donanımımızda çalıştırıp hız ölçümü yapmış değiliz; yayımlanan sonuçlarla kendi uygulama ölçümünüzü ayırmanız önemli.
Ollama ile küçük bir denemeye başlamak
Ollama'nın model sayfası, aşağıdaki komutu yayımlıyor. Uyumlu bir Ollama kurulumu ve yeterli donanım gerektirir; ilk çalıştırma model dosyalarını indirir:
ollama run inkling-2-mini
İlk denemede tüm kod deponuzu vermek yerine küçük, gizli bilgi içermeyen bir görev kullanın. Örneğin bir fonksiyondaki sınır durumu açıklamasını isteyin. Sonra kendi beklenen cevabınızla karşılaştırın. Modelin mantıklı bir metin üretmesi, değişikliğin testlerden geçtiği anlamına gelmez.
Ollama servisi yerelde çalışırken, Bash benzeri bir terminalden chat API'si ile tekrarlanabilir bir istek gönderebilirsiniz:
curl http://localhost:11434/api/chat \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "inkling-2-mini",
    "stream": false,
    "messages": [{
      "role": "user",
      "content": "Bir API yanıtında 401 ve 403 farkını kısa bir örnekle Türkçe açıkla."
    }]
  }'
Bu örnek yalnızca yerel sohbet isteğidir; üretim entegrasyonu veya yetkilendirme katmanı değildir. stream: false, yanıtı parça parça okumak yerine tek yanıt olarak almak için kullanılıyor. Yerel servisi internete açmak denemeye başlamak için gerekli değil.
Uzun bağlamı kapasite planından ayırmayın
Model kartında bir milyon tokena kadar bağlam desteği belirtiliyor. Bu mimari üst sınır, her çalıştırıcının varsayılanı veya 32 GB'lık bir cihazda aynı uzunluğun rahatça işlenebileceği sözü değildir. Ağırlıkların yanında bağlam önbelleği, uygulama ve işletim sistemi de bellek tüketir.
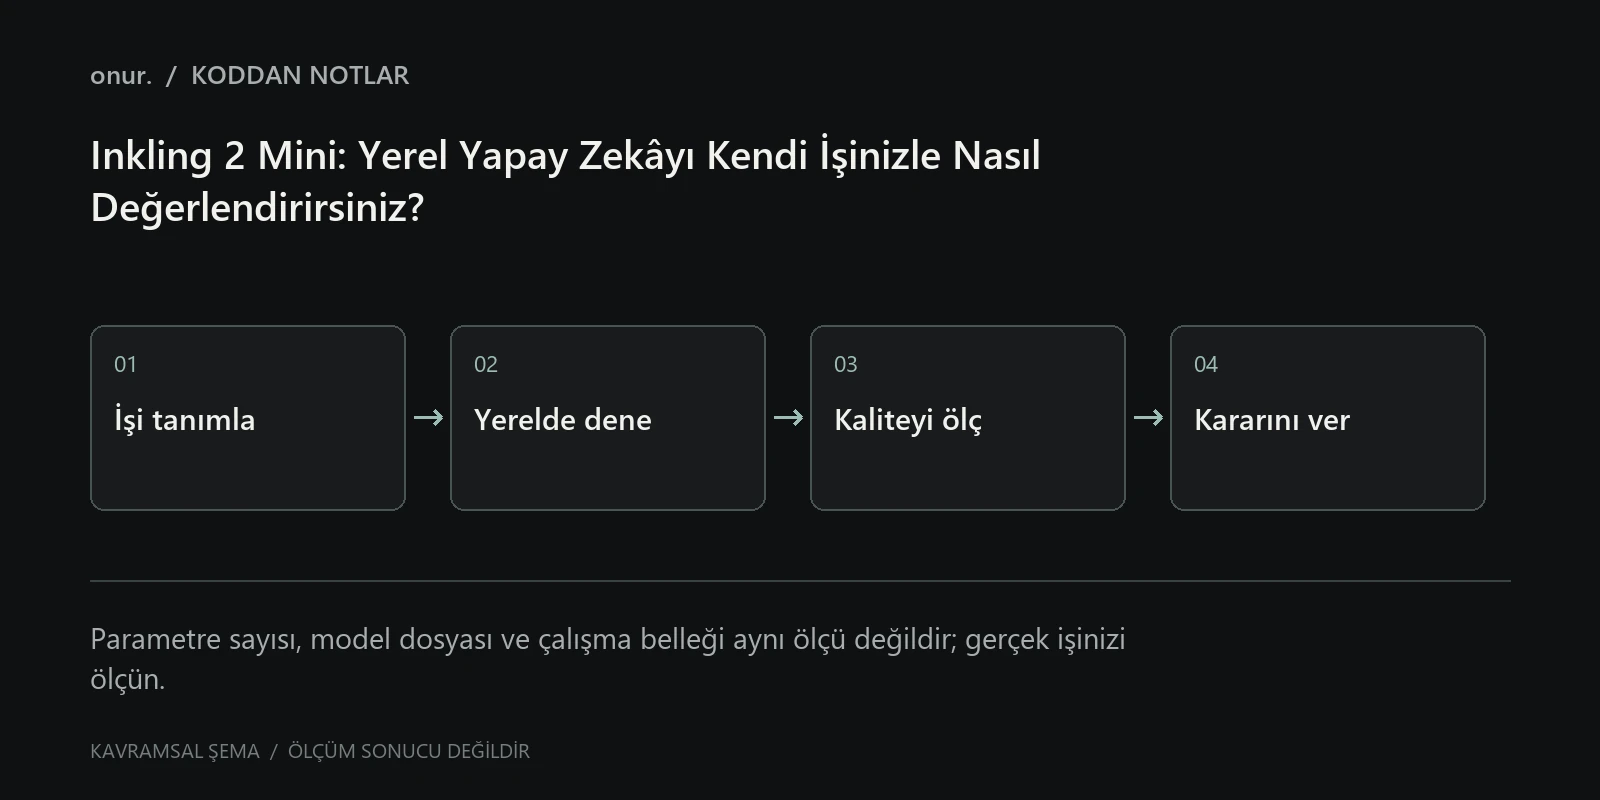
Benim önerim testleri kısa görevlerle başlatmak, sonra belge uzunluğunu ve eşzamanlı istek sayısını kontrollü artırmak. Her aşamada ilk yanıt süresini, tamamlanma süresini, tepe bellek kullanımını ve doğru cevap oranını kaydedin. Böylece “çalıştı” ile “iş yükümüzü taşıyor” arasındaki farkı görebilirsiniz.
Kendi işinize uygun değerlendirme nasıl kurulur?
Örneğin Türkçe destek taleplerini sınıflandıracaksanız en az üç grup hazırlayın: açık talepler, birden fazla niyet içeren talepler ve karar verilemeyecek kadar eksik talepler. Beklenen sınıfı veya insan incelemesine yönlendirme kararını önceden belirleyin. Modelin bilmediğinde durabilmesini de başarı ölçütüne ekleyin.
Kod asistanında ise yalnızca üretilen satır sayısını ölçmeyin. Test sonucu, gereksiz dosya değişiklikleri ve geri alınması zor işlemler daha anlamlıdır. Yapay zekâ ile yazılan kodu doğrulama rehberindeki yaklaşımı burada da kullanabilirsiniz.
Yerel model veri akışını kontrol etmenize yardımcı olabilir; fakat ajana bağlanan arama servisi, harici araç veya günlükleme altyapısı ayrıca veri gönderebilir. Araç yetkilerini görevle sınırlandırın ve her bağlantıyı ayrı inceleyin. Son karar, tanıtımdaki sıralamaya göre değil, aynı gerçek görevlerde ölçtüğünüz kalite ve işletim maliyetine göre verilmeli.
Model dosyaları ve desteklenen çalıştırıcılar için resmî Hugging Face deposunu kullanabilirsiniz. İndirme kaynağını, sürümü ve kullanılan ağırlık biçimini test kaydına eklemek, daha sonra aynı sonucu yeniden üretmeyi kolaylaştırır.
BİRLİKTE ÖĞRENELİM
Yorumlar
Henüz yorum yok. Düşünceni paylaşarak sohbeti başlatabilirsin.
Bir Yorum Bırak.
Katkılarını ve deneyimlerini duymak isterim. Yorumlar yayınlanmadan önce incelenir.