
Gemini API ile Office Belgeleri: Yalnızca Gereken Sayfaları İşlemek
Gemini API’nin belge ve elektronik tablo desteği, dosyanın tamamı yerine ilgili bölüme odaklanmayı kolaylaştırıyor. Sayfa seçimini, örnek belge bloğunu, veri gizliliği sınırlarını ve çıktıyı doğrulamak için gerekli uygulama kontrollerini açıklıyorum.
Bir yapay zekâya yüz sayfalık dosyanın tamamını gönderip yalnızca üç sayfasını sormak, hem maliyet hem de sonuç kalitesi açısından gereksiz yük yaratabiliyor. Gemini API’nin 18 Kasım 2026 güncellemesi, Office ve OpenDocument dosyalarını işleme desteğini ve belgenin seçilen bölümlerini modele sunma seçeneklerini genişletiyor.
Bu yenilik, sohbet ekranına dosya eklemekten ibaret değil. Doküman analizi yapan bir uygulamada hangi sayfanın, hangi hücre aralığının ve hangi temsilin kullanılacağını daha açık tarif edebilmek anlamına geliyor. Özellikle teklif, rapor ve elektronik tablo işleyen geliştiriciler için değerli.
Yeni destek neyi kapsıyor?
Gemini API değişiklik günlüğü, Word, PowerPoint ve Excel gibi Office biçimleriyle OpenDocument dosyalarının işlenmesini; belge, tablo, ses ve videoda bölüm seçimini duyuruyor. Duyurunun tarihi 18 Kasım. Daha önce açıklanan model özellikleriyle bunu aynı gelişme olarak değerlendirmemek gerekiyor.
Belge işleme dokümanında document bloğu için processing seçenekleri açıklanıyor. Sayfa başlangıcı ve bitişi 1’den başlıyor ve sınırlar dahil ediliyor. Metin ile sayfa görüntüsü katmanları farklı ihtiyaçlara karşılık geliyor. Elektronik tablolarda ise sayfa numarası yerine çalışma sayfası ve hücre aralığı seçilebiliyor.
Bir sözleşmenin belirli maddelerini okumakla, sayfadaki yerleşimi ve imza alanlarını incelemek aynı görev değil. İlkinde metin yeterli olabilir; ikincisinde görsel temsil gerekebilir. Seçimi “en yüksek çözünürlük her zaman iyidir” alışkanlığıyla değil, sorunuzun ihtiyacıyla yapın.
Üç sayfalık bir inceleme örneği
Aşağıdaki JSON, önceden yüklenmiş bir PDF için istek içindeki belge bloğunun örneğidir; tek başına çalışan bir HTTP isteği değildir. URI yer tutucudur. Güncel Interactions API belgelerindeki alanlarla hazırlanmıştır; ücretli API üzerinde canlı bir performans testi yapılmış değildir.
{
  "type": "document",
  "uri": "YUKLENEN_DOSYANIN_URI_DEGERI",
  "mime_type": "application/pdf",
  "processing": {
    "type": "static",
    "page_options": {
      "start_page": 8,
      "end_page": 10,
      "content_layers": ["page_text"]
    }
  }
}
Burada hedef 8, 9 ve 10. sayfalar. Uygulama arayüzünde “sayfa 8” yazıp arka tarafta sıfır tabanlı bir dizi indeksi kullanıyorsanız kayma hatası oluşabilir. Bu küçük ayrıntı, yanlış sözleşme maddesinin özetlenmesine kadar gidebilir. Geliştirme testinde her sayfasında belirgin numara bulunan sentetik bir PDF kullanmak bu hatayı erken yakalar.
Bölüm seçimi, hassas veriyi dosyadan silmez
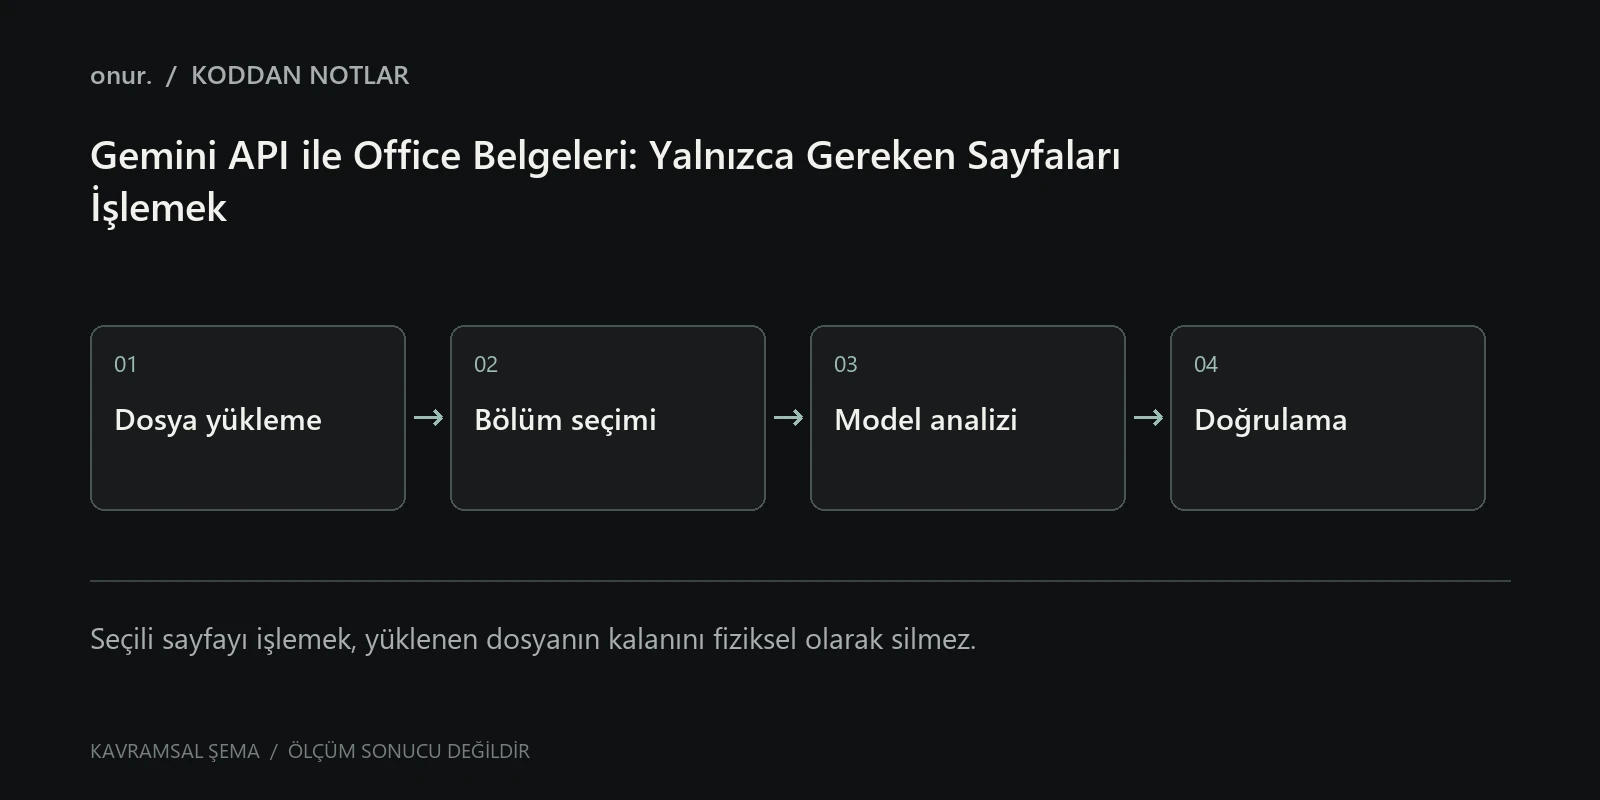
Burada kritik ayrım şu: modelin işlediği bölümü sınırlandırmak, yüklediğiniz dosyanın geri kalanını fiziksel olarak çıkarmakla aynı işlem değil. Dosyanın tamamı yükleniyorsa gizli bölümlerin hiç aktarılmadığını söyleyemezsiniz. Doküman ayrıca tam dosya sınırlarının bölüm seçildiğinde de geçerli olduğunu belirtiyor.
Bu nedenle müşteri belgesinde işlenmemesi gereken sayfalar varsa, dosyayı yüklemeden önce uygulamanızda ayırmak veya uygun biçimde redakte etmek ayrı bir karardır. Elektronik tablodaki görünür hücre aralığını seçmek de kendi başına bir veri sızdırmazlık sınırı olarak kullanılmamalı.
Files API rehberi, dosyanın yüklenmesi ve daha sonra bir referansla kullanılmasını anlatıyor. Dosya yaşam döngüsünü de uygulama tasarımına katın: yükleme başarısız olursa ne olacak, belge değiştiğinde eski referans nasıl anlaşılacak, iş tamamlandığında dosyaya hâlâ ihtiyaç var mı?
Sonucu nasıl güvenilir hâle getirebilirsiniz?
Örnek görev olarak “Bu üç sayfadaki ödeme tarihlerini çıkar” isteğini düşünelim. Sonucu serbest paragraf yerine tarih, tutar, para birimi ve kaynak sayfa alanlarıyla almak işinizi kolaylaştırır. Ancak biçimin düzgün olması, bilginin doğru olduğu anlamına gelmez.
Ben bu akışta üç kontrol öneririm: istenen bölümün doğru seçilmesi, çıktının beklenen şemaya uyması ve kritik değerlerin kaynak belgeyle karşılaştırılması. Yapay zekâ JSON çıktısını doğrulama yazısı ikinci adımı ayrıntılandırıyor. Modelin bulamadığı alanı boş bırakabilmesine izin verin; her hücreyi doldurma zorunluluğu tahmin üretmesini teşvik edebilir.
İlk denemede maliyet ve doğruluk için kendi küçük ölçüm setinizi kurun. Tam belge ile seçili bölümün yanıtlarını aynı sorular üzerinde karşılaştırın. Kullanım metriklerini kaydedin; duyurudaki verimlilik beklentisini kendi dosyalarınızda ölçmeden kesin tasarruf oranı olarak sunmayın.
BİRLİKTE ÖĞRENELİM
Yorumlar
Henüz yorum yok. Düşünceni paylaşarak sohbeti başlatabilirsin.
Bir Yorum Bırak.
Katkılarını ve deneyimlerini duymak isterim. Yorumlar yayınlanmadan önce incelenir.