
Gemini 4 Neon: Bağlam Penceresi, Thinking Seviyeleri ve Geçiş
Gemini 4 Neon’un birleşik bağlam penceresi, düşünme seviyeleri ve ücretli API koşulları ne anlama geliyor? Modeli tek bir etkileyici demo yerine görev başarısı, gecikme ve gerçek maliyetle değerlendirmek için bir başlangıç rehberi.
Yeni bir model duyurusunda büyük bağlam penceresi veya yüksek performans iddiası dikkat çekiyor. Ancak bir geliştirici için asıl soru şu: Bu model benim görevimi doğru, kabul edilebilir sürede ve öngörülebilir maliyetle tamamlıyor mu? 18 Kasım 2026’da Gemini API’de genel kullanıma açılan Gemini 4 Neon bu soruyla değerlendirilmesi gereken modellerden biri. Gemini API değişiklik günlüğü.
Model kimliği gemini-4-neon. Google modeli karmaşık yazılım geliştirme, bilgi işleri ve analiz görevleri için konumlandırıyor. Bu yazı 20 Kasım 2026 tarihindeki resmî özellik ve fiyat bilgilerini temel alıyor; sağlayıcının performans iddialarını bağımsız test sonucu gibi sunmuyor.
Bir milyon token, iki ayrı milyon anlamına gelmiyor
Model kartında 1.048.576 token’lık birleşik bağlam penceresi yer alıyor. Girdi, düşünme ve çıktı aynı bütçeyi paylaşıyor. Varsayılan senkron çıktı sınırı 65.536 token; daha uzun üretim için long decode akışı gerekiyor. “Bir milyon token çıktı” ifadesini bütün büyük girdilerin üzerine eklenen bağımsız bir çıktı bütçesi gibi okumayın. Gemini 4 Neon model kartı.
Bu ayrım, büyük bir kod deposunu analiz ederken önem kazanır. Bağlamın çoğunu dosyalarla doldurursanız modelin açıklama, plan ve çıktı için kullanacağı alan daralır. İlgisiz logları, derlenmiş dosyaları ve tekrar eden bağımlılık içeriklerini göndermek, büyük pencereyi verimsiz kullanmanın kolay yoludur.
Thinking seviyesini görevle birlikte seçin
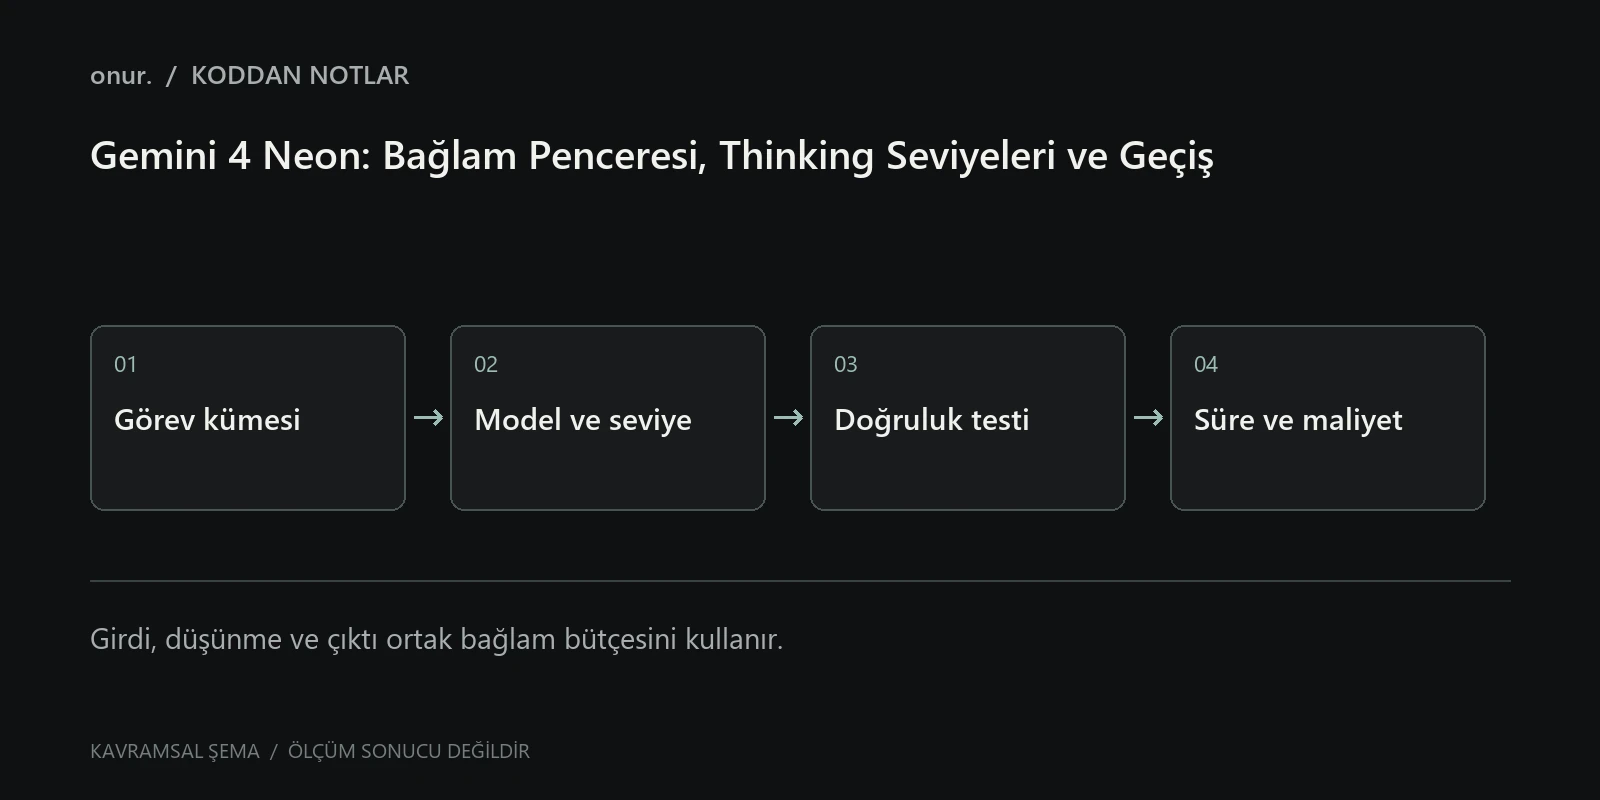
Neon low, medium, high ve xhigh seviyelerini destekliyor; varsayılan high. Daha yüksek seviyenin her görevde daha iyi maliyet/sonuç oranı vereceğini varsaymayın. Google’ın geçiş rehberi de seçim yapılırken değerlendirme sonuçlarına bakılmasını öneriyor. Neon yenilik ve geçiş rehberi.
Aşağıdaki örnek güncel Google GenAI SDK’sındaki Interactions biçimine dayanır:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input=(
        "Bu test senaryosunu incele: aynı stok kaydı için iki eşzamanlı "
        "sipariş geliyor. Olası yarış durumunu açıkla ve doğrulama planı yaz. "
        "Çalıştırmadığın bir testi başarılı olarak sunma."
    ),
    generation_config={
        "thinking_level": "high",
        "max_output_tokens": 8192,
    },
)

print(interaction.output_text)
Örnekteki 8.192 sınırı kısa bir deneme için bilinçli bütçe tercihidir; düşünme ve yanıt alanını birlikte kısıtlayabileceğinden tamamlanma durumunu inceleyin. Uzun bir rapor istiyorsanız aynı sınırı kopyalamayın. SDK sürümünüzün bu API’yi desteklemesi ve ücretli proje erişiminin bulunması gerekir. Bu kod burada canlı API’ye gönderilmedi.
Ücretli katman ve gerçek maliyet
Standart fiyatlandırmada bir milyon girdi token’ı 3 ABD doları, düşünme token’ları dahil bir milyon çıktı token’ı 15 ABD doları. Neon ücretsiz katmanda yer almıyor. Önbellek ve araç kullanımı için ayrıca koşullar bulunuyor. Resmî Gemini fiyatlandırması.
Araç ve önbellek etkisini dışarıda bırakan basit bir hesap düşünelim: 100.000 girdi ve toplam 10.000 faturalandırılan çıktı/düşünme token’ı yaklaşık 0,30 + 0,15 = 0,45 USD eder. Bu bir örnek hesaptır; gerçek kullanım kaydını faturanın yerine koyamazsınız. Model birkaç deneme yapıyor veya araç çağırıyorsa işin toplam maliyeti büyür.
Bu nedenle yalnızca token fiyatını karşılaştırmayın. Yanlış sonucu düzeltmek için gereken ek çağrılar, insan incelemesi ve başarısız işler de hesaba katılmalı. Daha pahalı bir model bazı görevleri tek seferde tamamlayabilir; daha ucuz bir model basit işler için yeterli olabilir. Hangisinin sizin işinizde geçerli olduğunu ölçmeden karar veremezsiniz.
Başlangıç için küçük ama anlamlı bir test kümesi
Yirmi gerçek görev seçmek, tek bir etkileyici demodan daha öğreticidir. Örneğin beş hata ayıklama, beş veri çıkarma, beş test üretimi ve beş teknik açıklama görevi kullanabilirsiniz. İçeriklerinizden kişisel verileri ve sırları çıkarın.
Her görev için beklenen çıktıyı önceden tanımlayın. Kodda hangi test geçmeli? JSON’da hangi alan zorunlu? Teknik açıklamada hangi iddia kaynak gerektiriyor? Model cevabını gördükten sonra başarı ölçütünü değiştirmeyin.
{
  "task_id": "invoice-extract-01",
  "model": "gemini-4-neon",
  "thinking_level": "high",
  "checks": {
    "schema_valid": null,
    "required_fields_correct": null,
    "unsupported_claims": null
  },
  "latency_ms": null,
  "total_cost_usd": null
}
Bu bir değerlendirme kayıt şeması örneğidir; alanlarda sonuç uydurmak yerine ölçüm yapılana kadar null kullanılır. JSON çıktısını şemayla doğrulama rehberi bu aşamada faydalı olabilir.
Büyük bağlam RAG ihtiyacını bitirir mi?
Hayır, bu sonucu yalnızca bağlam boyutundan çıkaramayız. Belge erişim yetkisi, güncellik, kaynak gösterme ve maliyet hâlâ uygulama tasarımının parçasıdır. Büyük pencere daha fazla içeriği bir seferde ele alabilme imkânı verir; hangi içeriğin gönderilmesi gerektiğini sizin yerinize belirlemez.
Çok sayıda kurum belgesinde soruya ilgili parçaları seçmek istiyorsanız RAG’e başlangıç yazısındaki yaklaşımı karşılaştırabilirsiniz. Küçük, tek seferlik bir analizde bütün belgeyi vermek mantıklı olabilirken sürekli çalışan bir aramada erişim ve geri getirme katmanı daha uygun olabilir.
Neon’a geçişi bir model adı değişikliğinden ibaret görmeyin. Önce görev kümenizi, hata ölçütünüzü ve bütçenizi belirleyin; sonra modelin bu sınırlar içinde ne yaptığını inceleyin. Resmî erişim ve fiyat koşulları değişebileceği için dağıtım öncesinde kaynakları yeniden kontrol edin.
BİRLİKTE ÖĞRENELİM
Yorumlar
Henüz yorum yok. Düşünceni paylaşarak sohbeti başlatabilirsin.
Bir Yorum Bırak.
Katkılarını ve deneyimlerini duymak isterim. Yorumlar yayınlanmadan önce incelenir.